Mac 万圣节模式:让本地视觉模型帮你守门
2026-11-03
English · 中文
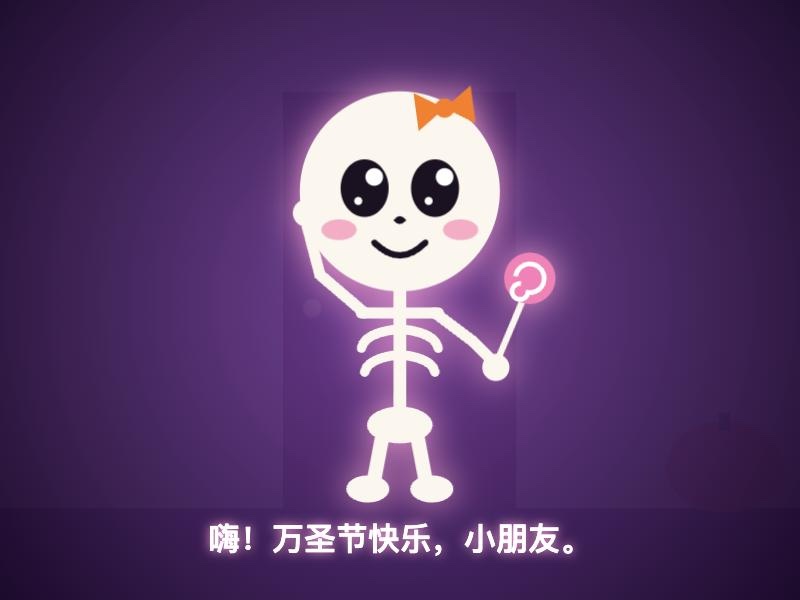
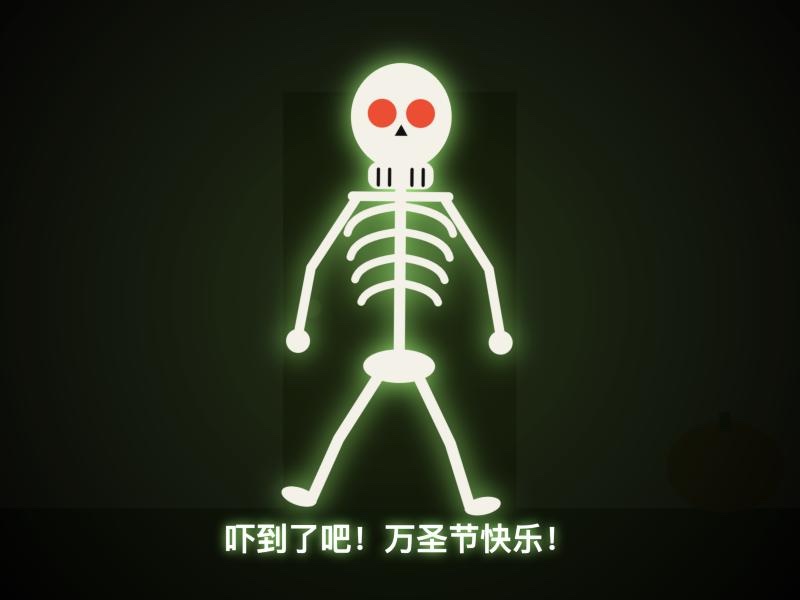
把 Mac 的摄像头对着门口。有人走进来,屏幕上就跳出一个骷髅,Mac 同时把问候读出来:小朋友和宠物看到的是蹦蹦跳跳、挥着棒棒糖的可爱骷髅,大人看到的是扑到眼前的吓人骷髅。
整个过程不经过云端。判断谁走了进来的,是在 Mac 上运行的视觉模型;它前面有一道门控,保证模型只在画面变化时才去看。
空房间,有人走进来,几秒后吓人骷髅扑了出来。这是在 M5 Pro 上录的屏,用的是从 Homebrew 安装的 halloween 0.1.0 和 Tempo9 1.3.0;声音是 Mac 扬声器的声音,由 Mac 自己的麦克风收录。
上手体验
brew install thinkspread/tap/tempo9
brew install thinkspread/tap/halloween
halloween
第一次运行会下载 Qwen3.5-9B(Q4_K_S)和配套的 Core ML 视觉编码器,约 6.4 GB。之后浏览器会打开 http://127.0.0.1:1031,点 🎃 开始,允许使用摄像头即可,不需要任何设置。
| 摄像头看到… | 它会说… | 骷髅 |
|---|---|---|
| 穿着万圣节服装的小孩 | 不给糖就捣蛋!服装真棒,拿两颗糖吧。 | 可爱 |
| 小孩 | 嗨!万圣节快乐,小朋友。 | 可爱 |
| 穿着奇装异服的大人 | 打扮得不错……可我更吓人。万圣节快乐! | 吓人 |
| 大人 | 吓到了吧!万圣节快乐! | 吓人 |
| 狗或猫 | 毛茸茸的客人,没有糖给你哦。 | 可爱 |
每位访客只吓一次,走出画面再进来会再吓一次。页面跟随浏览器语言显示中文或英文;开始前可以用角落的按钮切换,点开始后按钮会藏起来,不会出现在录像里。
一台机器,两个程序
halloween 本身不做推理。Tempo9 负责运行视觉编码器和语言模型,在 127.0.0.1:11435 上提供服务。halloween 先确认已有一个带视觉能力的 Tempo9 在运行,没有就替你启动一个;然后在自己的端口提供页面,只把三个请求转给 Tempo9:查询模型、编码一帧画面、提一个问题。
为什么不直接由 Tempo9 提供这个页面?换一个端口就是另一个源(origin),而 Tempo9 有意不发 CORS 头,这样浏览器里打开的其他网站都读不到它的回答。经由 halloween 转发,这一点就不会被破坏。
核心思路:不必逐帧调用模型
在我们的 M5 Pro 上,对一帧画面问一次模型需要 1.6–2.2 秒。如果对摄像头的每一帧都这么问,GPU 一整晚都闲不下来。所以每一帧都先经过更便宜的筛选:
- 像素检查:每秒把画面缩成 32×18 的小图,和上次量过的画面比较;没变就到此为止。
- 只跑视觉编码器:画面变了,就交给 Tempo9 的
POST /v1/vision/frame,它只运行编码器并返回向量。在 GPU 上,一帧 640 像素的画面约需 0.23 秒(20 次的中位数)。 - 很少才问模型:只有画面变化够大,模型才会看到它,问题只有一个:画面里是下面五种中的哪一种,还是都没有?
我们也试过把门控用的编码器放到 Neural Engine 上:同样的画面在那里要 2.1 秒,GPU 上只要 0.23 秒,所以门控留在 GPU。两者算出的向量一致(同一帧余弦相似度 0.9999)。
看变化最大的区域,而不是整帧
最初的门控只比较整帧的一个向量。这个向量是编码器在所有图块上的输出平均,局部变化会被周围不变的部分稀释:把摄像头画面中心 10% 换掉,整帧距离只变了 0.009;换掉 30%,也只有 0.023,都低于我们之前按摄像头实测定下的 0.025 触发阈值。一个只占画面不到三分之一的访客,根本叫不醒模型。
现在编码器还会按 4×3 网格给每个格子返回一个向量,门控取变化最大的那一格;触发阈值也随摄像头本身的噪声自动调整:取安静时相邻帧距离的滑动平均乘以 3.5,限制在 0.030–0.060 之间。用 Qwen3.5-9B 的编码器实测,变化最大区域的距离如下:
| 变化 | 距离 |
|---|---|
| 传感器噪声 | 0.013–0.023 |
| 曝光调亮 4% | 0.007 |
| 一块占画面 5% 的色块 | 0.076–0.096 |
| 占画面 10% 的色块 | 0.11–0.12 |
第一次上真摄像头学到的事
什么都没发生。 第一次用真摄像头测试时,按开始的人就坐在笔记本前。第一眼记下了「4. 大人」,而按原来的设计,第一眼不吓刚按按钮的人。规则只在「成为答案」的那一刻触发;同一个人一直在画面里,答案从未改变,骷髅也就一直没出来。现在第一眼和其他时候一样:按开始时画面里有谁,谁就先被吓一下。
下一位访客没被吓到。 为了反应快,万圣节模式在画面一动时就去问模型。这一眼可能正好拍到有人走出去一半,答案仍然是「大人」。在一次合成场景测试中,这个人走完剩下那段路,画面只变了 0.0192:不够触发下一次检查,又不能算画面没变。于是空着的门口从没被确认过,下一位访客成了「同一个答案」,没有骷髅。
修复有两处:画面停在模型没见过的样子时,再问一次;有人在画面里时,编码器至少每 2 秒运行一次,而不是 10 秒。同一个合成场景(canvas 摄像头、真实编码器、按画面内容作答的替身模型)中:
| 访客怎么离开 | 修复前:下一位被吓到 | 修复后:下一位被吓到 |
|---|---|---|
| 直接走出去 | 1/1,约 6 秒后才认出门口空了 | 1/1,1.7 秒后认出 |
| 在画面边上停一下再溜出去 | 0/1,始终没认出门口空了 | 2/2,1.4–1.5 秒后认出 |
两处修复加上按区域判断的门控之后,真摄像头前有人走进来,骷髅跳了出来,也就是文章开头的那段视频。这只是一次运行,不代表准确率;能不能认出服装、小孩和宠物,取决于模型的判断,它有时会出错。
测试配置:M5 Pro MacBook Pro(24 GB 统一内存),Tempo9 1.3.0,Qwen3.5-9B Q4_K_S,配套的 Core ML 视觉编码器运行在 GPU 上,贪心解码,关闭思考。
本地运行与隐私
页面只能连接提供它的那个服务(Content-Security-Policy: connect-src 'self'),也就是 127.0.0.1 上的 halloween;它只把三个请求转给 127.0.0.1 上的 Tempo9,别的一概不转。骷髅在页面里绘制,音效是合成的,朗读用 Mac 自带的声音。只有第一次下载模型和编码器时需要联网。
下一步
今年有点迟了,但明年你也可以用你的 Mac 做一个万圣节模式。
同样的门控也在 Tempo9 1.3.0 的内置页面里,只是没有万圣节装扮:运行 tempo9 --hf unsloth/Qwen3.5-9B-GGUF:Q4_K_S --tower auto,打开 http://127.0.0.1:11435,就能用自己写的规则盯着摄像头、屏幕或视频文件,比如「构建完成了」或「有人到门口了」。